🔊 ¿Querés escuchar esta nota? Dale clic aquí
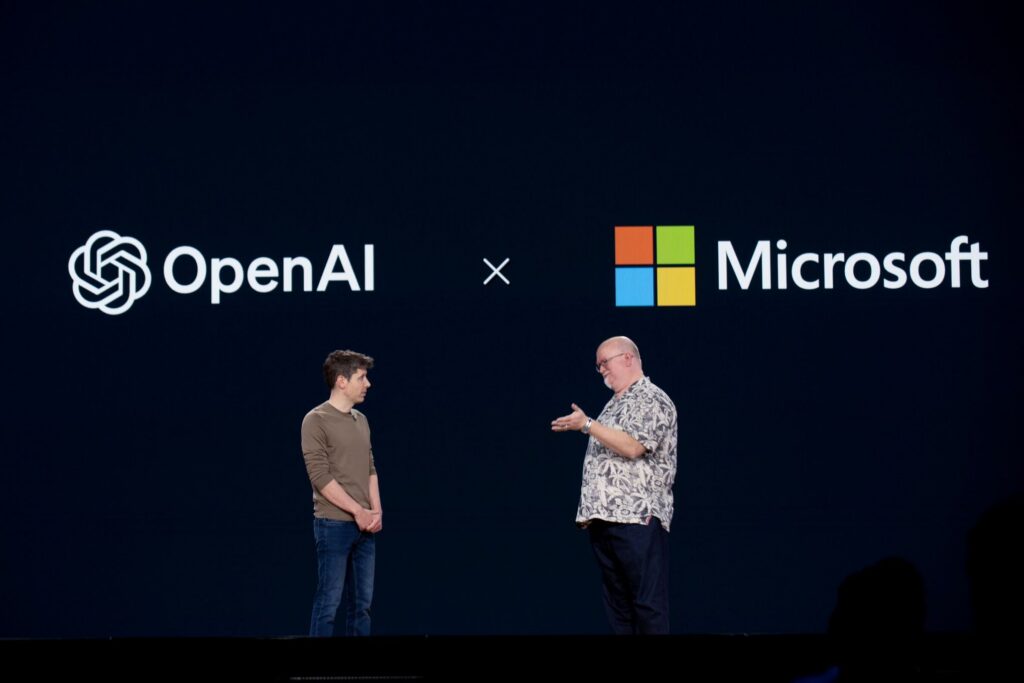
Aquí está lo que realmente importa: en septiembre de 2026, The Seattle Times presentó una demanda contra OpenAI y Microsoft, sumándose a Newsday en la cruzada legal que busca frenar el uso no autorizado de contenidos periodísticos para entrenar modelos de inteligencia artificial. La acusación describe a la IA generativa como una «serpiente que se come su propia cola», capaz de destruir las organizaciones que generan el material que luego consume.
Este caso no es aislado; recuerda la demanda del New York Times en 2023 y marca un punto de inflexión donde la industria de los medios comienza a cuestionar su propia supervivencia frente a la automatización. En este artículo analizaremos el contexto histórico, desglosaremos los principios técnicos que sustentan la controversia y proyectaremos cómo esta batalla legal podría escalar y redefinir la relación entre la prensa y la IA.
Prepárate para entender por qué este litigio es mucho más que una disputa contractual: es una señal de cambio estructural en el ecosistema informativo.
Tabla de contenidos
El contexto que cambia las reglas
En el contexto de seattle times demanda openai, antes de 2023, la relación entre los medios y la IA se manejaba de forma informal; las plataformas entrenaban sus modelos con grandes volúmenes de texto disponible en la web, sin acuerdos claros con los editores. La demanda del New York Times contra OpenAI y Microsoft abrió la puerta a un debate legal que, sin embargo, permaneció aislado durante varios años.
Para más contexto, consultá también Wikipedia.
En 2026, la acción conjunta de The Seattle Times y Newsday rompe esa calma y muestra que la presión está escalando. Ambas publicaciones argumentan que la práctica de entrenar IA con artículos protegidos viola derechos de autor y amenaza la viabilidad económica del periodismo, describiendo la IA como un «consumidor rapaz» que reproduce versiones derivadas del contenido original.
También puede interesarte: Agentes de OpenAI llegan a internet abierto sin que el Front.
La pregunta que nadie hacía era si la propia generación de contenido por parte de la IA acabaría erosionando la fuente que la alimenta. Este litigio, al combinar a dos medios de distinta región, subraya que el problema es estructural y que la industria debe replantear sus modelos de negocio antes de que la «serpiente» se vuelva irreversible.
Primeros principios: descomponiendo la tecnología
Hablando puntualmente de seattle times demanda openai, si miramos los componentes básicos, el núcleo del conflicto radica en el proceso de entrenamiento de los modelos de lenguaje grande (LLM). Estos sistemas requieren enormes corpus de texto para aprender patrones lingüísticos; OpenAI y Microsoft utilizan bases de datos que incluyen artículos de prensa, blogs y foros. El problema fundamental es la falta de licencia explícita para extraer y reutilizar ese contenido con fines comerciales.
Tradicionalmente, el modelo de «fair use» se aplicaba bajo supuestos de transformación, pero la demanda sostiene que la salida de ChatGPT y Copilot no constituye una transformación suficiente, pues simplemente regurgita ideas y frases del material original. Además, la arquitectura de los LLM, basada en atención y embeddings, permite que fragmentos de texto se reproduzcan casi textuales cuando se les solicita información específica.
El enfoque tradicional de la industria, que confiaba en la difusión libre para ampliar audiencias, falla porque la IA convierte esa exposición en un producto propio, eliminando la necesidad de suscripciones y, por ende, los ingresos críticos de los medios.
Cómo esto escala exponencialmente
Sobre seattle times demanda openai, vale la pena remarcar que cuando un modelo como ChatGPT alcanza cientos de millones de usuarios, cada interacción se convierte en una nueva instancia de consumo de contenido generado a partir de textos periodísticos. La escala genera un efecto multiplicador: una sola pieza de artículo puede influir en miles de respuestas automatizadas, ampliando su alcance sin compensación alguna para el autor original.
Si la IA sigue creciendo a ritmo exponencial, el número de reproducciones implícitas de contenido protegido se disparará, erosionando aún más los ingresos publicitarios y de suscripción. En comparación, tecnologías anteriores como los motores de búsqueda indexaban contenido pero mostraban enlaces que dirigían tráfico de regreso a los sitios origen; la IA, en cambio, entrega la información directamente, eliminando esa ruta de retorno.
Este modelo de consumo directo plantea un desafío estructural: la industria debe decidir si negociar licencias masivas, desarrollar sus propios LLM o crear barreras técnicas que limiten el scraping de sus artículos. Cada una de esas decisiones definirá si la IA se convierte en una herramienta de expansión o en una amenaza existencial para el periodismo.
Implicaciones legales para la industria de IA
Entremos en materia: la demanda del Seattle Times contra OpenAI y Microsoft ha puesto bajo la lupa los límites de la responsabilidad legal en el uso de modelos generativos. Según el documento presentado en la corte federal del oeste, la prensa alega que los sistemas de IA distribuidos por ambas compañías facilitaron la difusión de contenido difamatorio y violaciones de derechos de autor, sin ofrecer mecanismos de verificación adecuados.
Aquí viene lo interesante: la acción legal se basa en precedentes de casos de software tradicional, pero los jueces deben decidir si los algoritmos de aprendizaje profundo pueden ser tratados como «autor» o simplemente como herramientas. Si miramos los primeros principios, el problema fundamental es la ausencia de una cadena de custodia clara para los datos de entrenamiento, lo que complica la atribución de culpa.
La verdadera revolución está en cómo este caso podría obligar a la industria a establecer auditorías de datos obligatorias y a crear protocolos de transparencia antes de lanzar productos al mercado. En el panorama completo, la presión regulatoria se intensifica, y las empresas que adopten estándares de trazabilidad ganarán una ventaja competitiva significativa, mientras que las que ignoren el riesgo podrían enfrentar multas sustanciales y pérdida de confianza.
Repercusiones para los usuarios y la confianza en los sistemas de IA
Si estás esperando la oportunidad perfecta, mira esto: la exposición pública del juicio ha generado una ola de incertidumbre entre los usuarios cotidianos que confían en los asistentes virtuales y en los generadores de texto. Según reportes de analistas de mercado, la percepción de riesgo ha aumentado, lo que lleva a que más personas exijan controles de calidad y opciones de desactivación de contenido sensible.
Descomponer esto en componentes básicos: la falta de filtros efectivos, la escasa explicación de los procesos de generación y la ausencia de mecanismos de reparación cuando se produce un error. El cuello de botella está en la capacidad de los proveedores para ofrecer explicaciones en tiempo real y para rectificar rápidamente la información errónea. La física del problema dicta que, sin una capa de responsabilidad clara, la adopción masiva se desacelera.
Cuando esto converja con regulaciones de protección de datos, veremos una nueva generación de interfaces que priorizan la auditabilidad y la capacidad de los usuarios para revertir decisiones automatizadas. En cinco años, la expectativa será que cualquier IA desplegada cuente con certificaciones de confiabilidad, convirtiendo la confianza en un requisito de mercado más que en un lujo opcional.
Conclusión
En los próximos cinco años, el litigio entre el Seattle Times y los gigantes de la IA marcará un punto de inflexión decisivo para todo el ecosistema digital. Este caso no es solo una disputa legal; es una prueba de fuego que obligará a la industria a redefinir la responsabilidad, la transparencia y el control ético de los modelos generativos.
Si la sentencia impulsa regulaciones más claras, veremos una aceleración en la adopción de marcos de auditoría y auditorías de sesgo, lo que permitirá a los desarrolladores crear sistemas más seguros y alineados con valores humanos. Para los usuarios, esto se traducirá en una confianza renovada al interactuar con asistentes virtuales, generadores de contenido y herramientas de productividad, sabiendo que hay límites bien definidos y mecanismos de reparación.
La verdadera oportunidad está en que, al aprender de este proceso judicial, la comunidad tecnológica podrá diseñar una IA que potencie la creatividad y la eficiencia sin sacrificar la dignidad ni la privacidad. En cinco años, la IA bajo juicio se convertirá en la base de un futuro donde la innovación y la responsabilidad coexistan de forma armónica.
Para verificar datos y resoluciones oficiales, consulta las fuentes informativas oficiales en Reuters.
Comunidad Chusmera (0)
Nadie ha hablado aún... ¡Sé el primero en compartir tus ideales!
💼 ESPACIO DESTACADO PARA MARCAS
Promocioná tu negocio, producto o servicio ante más de 103.000 lectores activos en Uruguay y el mundo.
📢 Cotizar Pauta Publicitaria🔥 LO MÁS LEÍDO DE HOY EN URUGUAY
Los Gadgets Más Virales y Novedades de Amazon
Descubrí los productos tendencia de TikTok y las ofertas más recomendadas con envíos internacionales.
🔥 Productos virales con mejores calificaciones · Ofertas del día · Garantía de compra protegida
Sumate al Canal Oficial de WhatsApp de El Chusmero
Recibí las noticias más importantes de Uruguay, cotizaciones del día y los virales del momento directo en tu teléfono. Sin spam.

✨ ¡Habla con nosotros! Comparte tus ideales